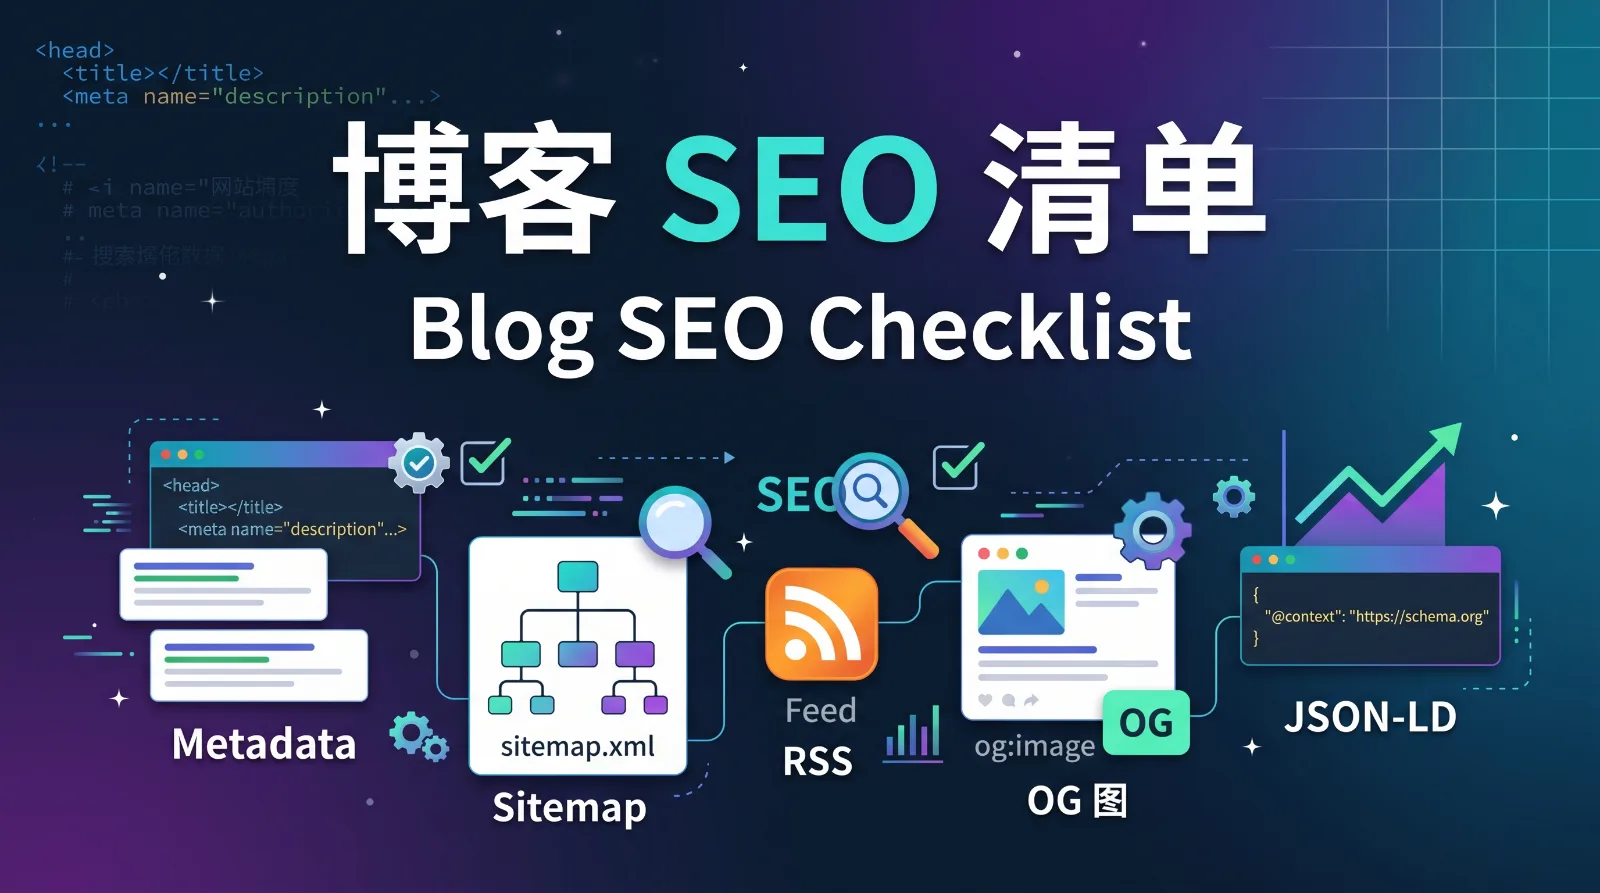
SEO 相关的活儿,陆续配了五样:metadata、sitemap、robots、RSS、OG 图,外加一个 JSON-LD
总览大概内容是这样的:
搜索引擎能不能看懂你的网站
│
├─ metadata   → 每张页面的"名片":标题、描述、规范地址
├─ sitemap    → 递给爬虫的完整"菜单":我有哪些页面
├─ robots     → 门上贴的纸条:哪里能进,哪里别去
├─ RSS        → 老派但优雅的"推送":更新了主动喊一嗓子
├─ OG 图      → 分享到社交网络时的"门面照"
└─ JSON-LD    → 给机器看的"自我介绍":这是一篇文章,作者是谁,什么时候发的
一、metadata:所有 SEO 的地基
metadata 就是「描述这个页面的信息」,它不显示在页面上,但搜索引擎、社交平台、浏览器会读它。
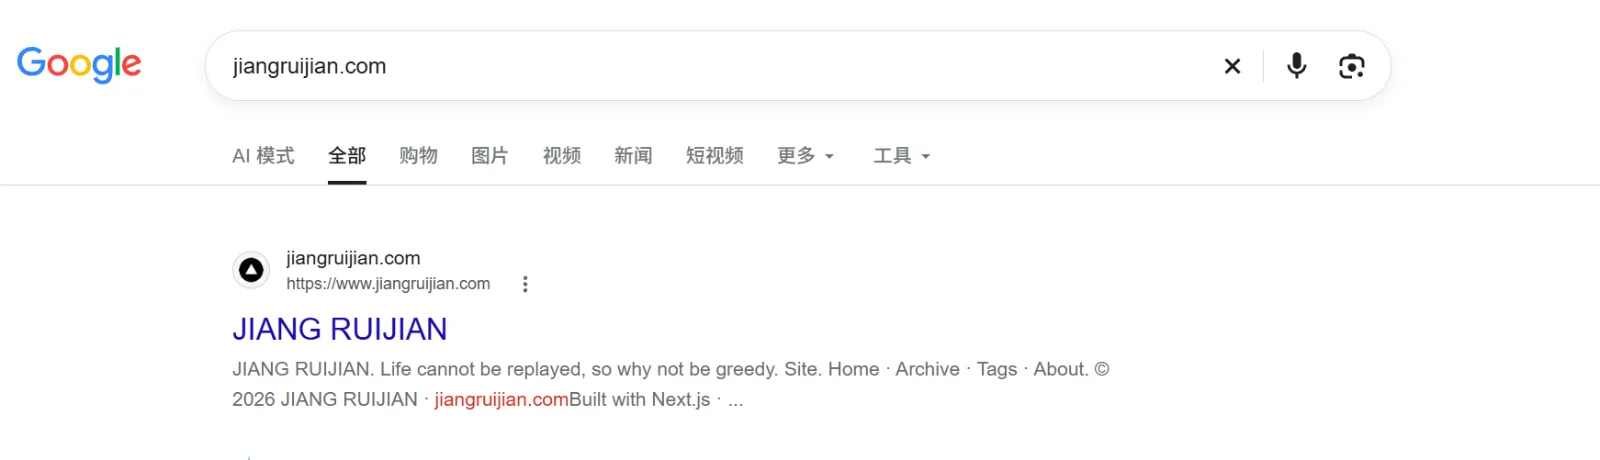
其实每天都在看 metadata,只是没注意。Google 搜索结果里,蓝色标题是 <title>,下面那段灰色描述是 <meta name="description">。
我的根布局,src/app/layout.tsx 是这么写的:
export const metadata: Metadata = {
  metadataBase: new URL(siteConfig.url),
  title: {
    default: siteConfig.name,
    template: `%s · ${siteConfig.name}`,
  },
  description: siteConfig.description,
  alternates: {
    types: {
      "application/rss+xml": `${siteConfig.url}/feed.xml`,
    },
  },
  openGraph: {
    type: "website",
    siteName: siteConfig.name,
    // ...
  },
};metadataBase它告诉 Next.js:我这个站的域名是什么。你可能会问,这不是服务器自己就知道的事吗?还真不是。Next 的 metadata 在渲染时就要把链接拼完整,你不声明域名,它只能拿 localhost:3000 之类的兜底。title.template省的是重复劳动。 模板写成 %s · JIANG RUIJIAN,页面里只写标题,拼装的事交给框架alternates.types那几行,是给 RSS 装的门铃。 配上之后,页面<head>里多一个<link rel="alternate" type="application/rss+xml">,RSS 阅读器看到你的站点就知道这家有 feed。你不用到处贴订阅地址,读者点一下地址栏的图标就能找到。第四节那份 RSS,就靠这个被人发现。- 站点级的 openGraph 是兜底。 首页和没单独配置的页面会用到它。文章页必须有自己的——这是
generateMetadata的活儿:
export async function generateMetadata({ params }: Props): Promise<Metadata> {
  const { slug } = await params;
  const post = await getPost(slug);
  if (!post) return { title: "文章不存在" };

  return {
    title: post.title,
    description: post.excerpt ?? undefined,
    alternates: {
      canonical: `/posts/${post.slug}`,
    },
    openGraph: {
      type: "article",
      publishedTime: toIsoString(post.createdAt),
      // 有封面用封面;没有就交给同路由的 opengraph-image.tsx 自动生成
      ...(post.coverImage ? { images: [{ url: post.coverImage }] } : {}),
    },
    twitter: { card: "summary_large_image", /* ... */ },
  };
}
二、sitemap:递给爬虫的菜单
sitemap 的道理大概就是:把「我这个站有哪些页面」列成一份 XML,放在约定位置 /sitemap.xml。没有它,爬虫只能顺着链接一点点摸;有了它,菜单直接递过去。尤其是那些链接埋得深、外链为零的页面——个人博客的新文章,基本都是这个待遇。
我的 src/app/sitemap.ts:
export const dynamic = "force-dynamic";

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const [posts, tags] = await Promise.all([allPublishedPostMeta(), listPublicTagsWithCounts()]);

  const staticRoutes: MetadataRoute.Sitemap = [
    { url: absUrl("/"), changeFrequency: "daily", priority: 1 },
    { url: absUrl("/posts"), changeFrequency: "daily", priority: 0.8 },
    { url: absUrl("/tags"), changeFrequency: "weekly", priority: 0.7 },
    { url: absUrl("/about"), changeFrequency: "monthly", priority: 0.5 },
  ];

  const postRoutes = posts.map((post) => ({
    url: absUrl(`/posts/${encodeURIComponent(post.slug)}`),
    lastModified: toDate(post.updatedAt),
    changeFrequency: "weekly" as const,
    priority: 0.7,
  }));
  // …标签页同理,priority: 0.4
}
我的文章存数据库,而 Next 构建时不该访问数据库(Vercel 的构建环境连不上你的库)。加 force-dynamic,sitemap 在每次请求时实时生成——爬虫每次来拿到的都是最新菜单,发新文章不用重新部署。
lastModified 是整份 sitemap 里最值钱的字段。爬虫的资源有限,不可能每次都把你的全站重抓一遍。lastModified 等于告诉它:这页上次改动是周二。它就会优先去抓新改动的页面。我用的文章的 updatedAt——改一次老文章,爬虫也会再来看一眼。
三、robots.txt:门上贴的纸条
src/app/robots.ts,一共十几行:
export default function robots(): MetadataRoute.Robots {
  return {
    rules: {
      userAgent: "*",
      allow: "/",
      disallow: ["/admin/", "/api/"],
    },
    sitemap: absUrl("/sitemap.xml"),
  };
}
它总共就做两件事:划禁区,指路 sitemap。
robots.txt 是君子协定,不是门锁。 它的原理是爬虫「自觉遵守」。Googlebot、Bingbot 这些正规军都守规矩,但它是防不住任何恶意扫描器的,这个需要明确知道。
顺着这个,坦白一个有意思的权衡:把 /admin/ 写进 robots.txt,等于在公开文件里告诉全世界「我这站有个后台」。 安全圈确实有人主张别暴露敏感路径。但我的账是这么算的:比起藏路径,我更怕爬虫把后台的登录页、会话过期页收进搜索结果——那才是真的难看。路径本身不构成秘密,目录扫描一抓一大把;藏得住后台的入口才是本事。两边一权衡,划禁区更划算。当然,前提是后台真的有防线。不然你藏的就不是路径,是心理安慰。
sitemap 字段,就是在 robots.txt 末尾加一行 Sitemap: https://你的域名/sitemap.xml。有些爬虫不逛 Search Console,它们认这条约定俗成的指路牌。
四、RSS:一个主动推送的订阅器
RSS 是一个「订阅源」文件,读者用 RSS 阅读器订阅它,你更新博客,阅读器就可以自动把新文章推给读者。
我的 src/app/feed.xml/route.ts 是个手写 XML 的 Route Handler
export async function GET() {
const posts = await allPublishedPosts();
const items = posts.map((post) => {
const link = absUrl(`/posts/${encodeURIComponent(post.slug)}`);
return `<item>
<title>${escapeXml(post.title)}</title>
<link>${escapeXml(link)}</link>
<guid>${escapeXml(link)}</guid>
<pubDate>${toUtcString(post.createdAt)}</pubDate>
<description>${escapeXml(post.excerpt ?? "")}</description>
<content:encoded>${escapeXml(post.contentMd)}</content:encoded>
</item>`;
}).join("\n");
// …channel 头部 + Content-Type: application/rss+xml
}
function escapeXml(value: string): string {
return value
.replace(/&/g, "&").replace(/</g, "<").replace(/>/g, ">")
.replace(/"/g, """).replace(/'/g, "'");
}五、OG 图:社交网络上的分享图
OG 是 Open Graph 的缩写,Facebook 最早搞的一套协议。它规定:网页可以在 <head> 里放一组 og: 开头的 meta 标签,告诉社交平台「这个页面是什么、该显示什么」。
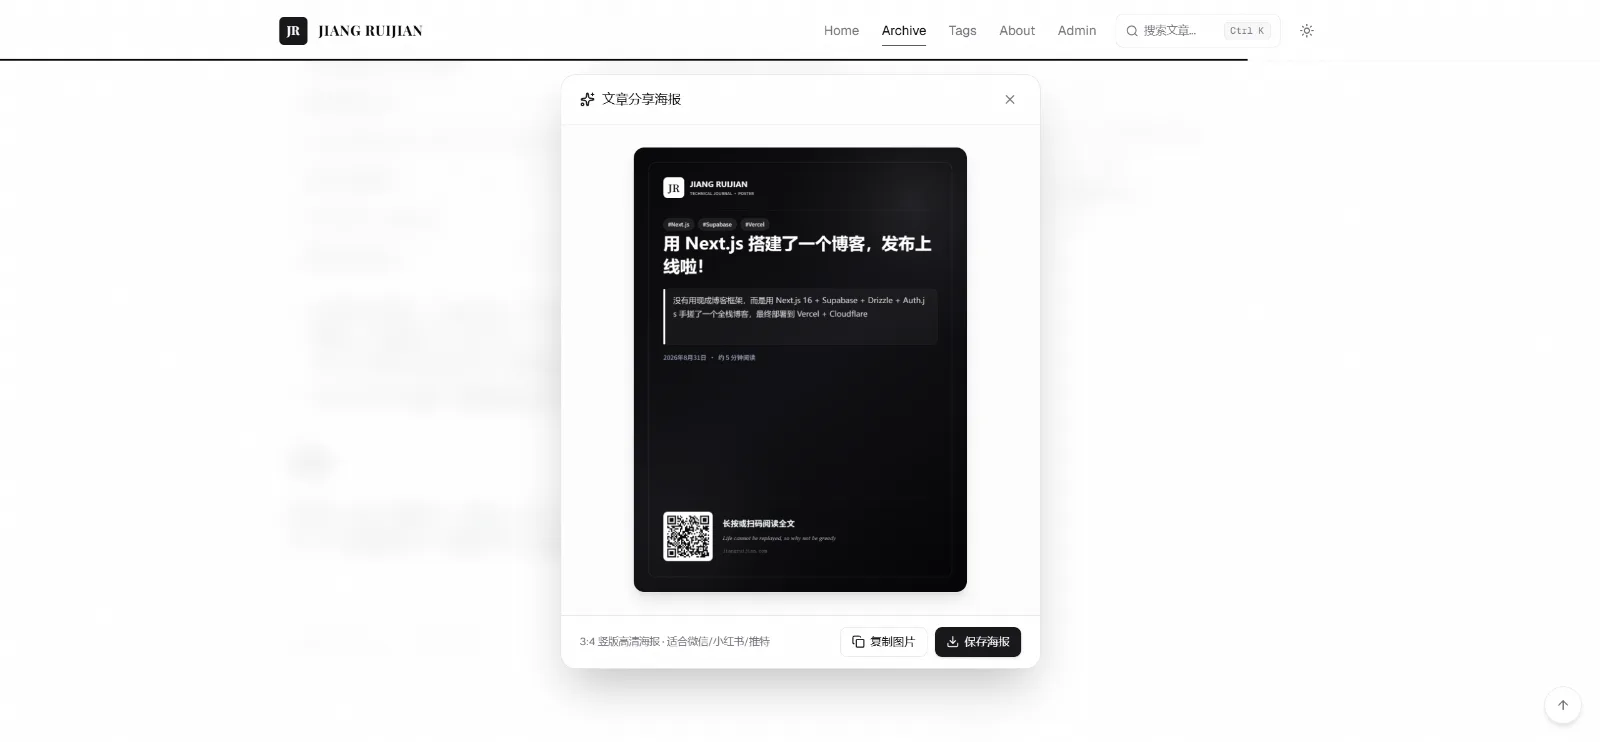
export const size = { width: 1200, height: 630 };
export const contentType = "image/png";

export default async function Image({ params }: Props) {
  const { slug } = await params;
  const post = await getPublishedPostBySlug(decodeRouteParam(slug));
  const title = post?.title ?? siteConfig.name;

  return new ImageResponse(
    <div style={{ width: "100%", height: "100%", display: "flex",
                  flexDirection: "column", justifyContent: "space-between", /* … */ }}>
      {/* 顶部品牌 / 中部大标题+摘要 / 底部标签+日期 */}
    </div>,
    { ...size },
  );
}
六、JSON-LD:给机器看的自我介绍
前面的东西都是在给机器传递信息,告诉机器我这页面大概是什么。而 JSON-LD 是一段嵌在页面里的结构化数据,用 schema.org 的词汇表,逐字段自我介绍。
我的文章页输出 BlogPosting 类型:
const jsonLd = {
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  headline: post.title,
  description: post.excerpt ?? undefined,
  datePublished: toIsoString(post.createdAt),
  dateModified: toIsoString(post.updatedAt),
  url: postUrl,
  image: [post.coverImage || absUrl(`/posts/${post.slug}/opengraph-image`)],
  author: { "@type": "Person", name: siteConfig.name, url: siteConfig.url },
  keywords: post.tags.map((item) => item.name).join(", "),
};
七、一揽子校验清单
| 检查项 | 在哪配 | 怎么验证 |
|---|---|---|
| metadataBase + title 模板 | 根布局 layout.tsx | 查看页面源码 <head>,别让 localhost 上线 |
| 每页 metadata + canonical | generateMetadata | 源码里 canonical 指向正式地址 |
| sitemap(含 lastModified) | app/sitemap.ts | 访问 /sitemap.xml,Search Console 提交 |
| robots 划禁区 + 指路 | app/robots.ts | 访问 /robots.txt |
| RSS 全文输出 | Route Handler | W3C Feed Validator,阅读器实测订阅 |
| OG 图自动生成 | opengraph-image.tsx | opengraph.xyz / 发 Telegram 看卡片 |
| JSON-LD(记得转义 <) | 页面内 <script> | validator.schema.org |